Claude Codeを使っていて一番地味にストレスだったのが、「セッションが変わるたびに、また同じことを説明し直す」ことでした。
「うちのブログはです/ます調だけど硬すぎないトーンで」「本番のDB操作は必ずスラッグベースで」みたいなルールを、毎回ゼロから伝え直すのは正直かなり面倒です。
このブログもClaude Codeで運営しているので、この問題はまさに自分ごとでした。今回は、そのために作り込んできた「CLAUDE.md」と「メモリシステム」を、あらためて棚卸ししてみようと思います。
🎥 この記事の内容は動画でも解説しています。
CLAUDE.mdだけでは、途中から足りなくなった
最初は、プロジェクト直下にCLAUDE.mdを1枚置くだけでした。
公式ドキュメントによると、Claude Codeは毎回のセッション開始時にこのファイルを読み込んで、プロジェクトの文脈を掴む仕組みになっています(公式ドキュメント「How Claude remembers your project」)。
最初のうちはこれで十分だったんですが、ルールが増えるにつれて1枚のファイルがどんどん肥大化していって、そのうち「WordPressのPHPの書き方」と「CSSの命名規則」と「JSの初期化パターン」が全部同じファイルの中に混在するようになってしまいました。
目的が違うルールが1つのファイルに混ざると、後から見返すときに「今探してるのはどのルールだっけ」と迷う時間が地味に増えます。
これはよくないなと思って、途中からrules/というディレクトリを切って、ドメインごとに1ファイル1目的で分割することにしました。
ルールは「1ファイル1目的」に分けている
今のうちの構成では、WordPress周りのルールだけでもこう分かれています。
rules/
  wordpress.md   … WordPress / PHP / ACFの実装ルール
  html.md        … HTML / マークアップの実装ルール
  css.md         … SCSS / FLOCSS / BEM / コンポーネント設計のルール
  javascript.md  … Vanilla JS / DOM / イベント初期化のルール
  workflow.md    … 実装・調査・修正を進める際の判断基準
CLAUDE.md自体には具体的なルールをほぼ書かず、「WordPress案件のときはこのファイル群を見てね」という道しるべだけを置いています。
中身の例を1つ挙げると、html.mdには「装飾目的のみでテキストを持たない要素は::before/::after疑似要素に置き換える、不要なWrapperは作らない」というルールがあって、具体例として「バイリンガル見出しは別要素にせずdata-en属性+疑似要素で表示する」「連番表示はハードコードせずcounter-reset/counter-incrementを使う」まで書いてあります。
ここまで具体的に書いておくと、新しいセッションでも毎回同じ判断で実装してくれるので、地味にありがたいです。
一方で「メモリ」は、自分では書いていない
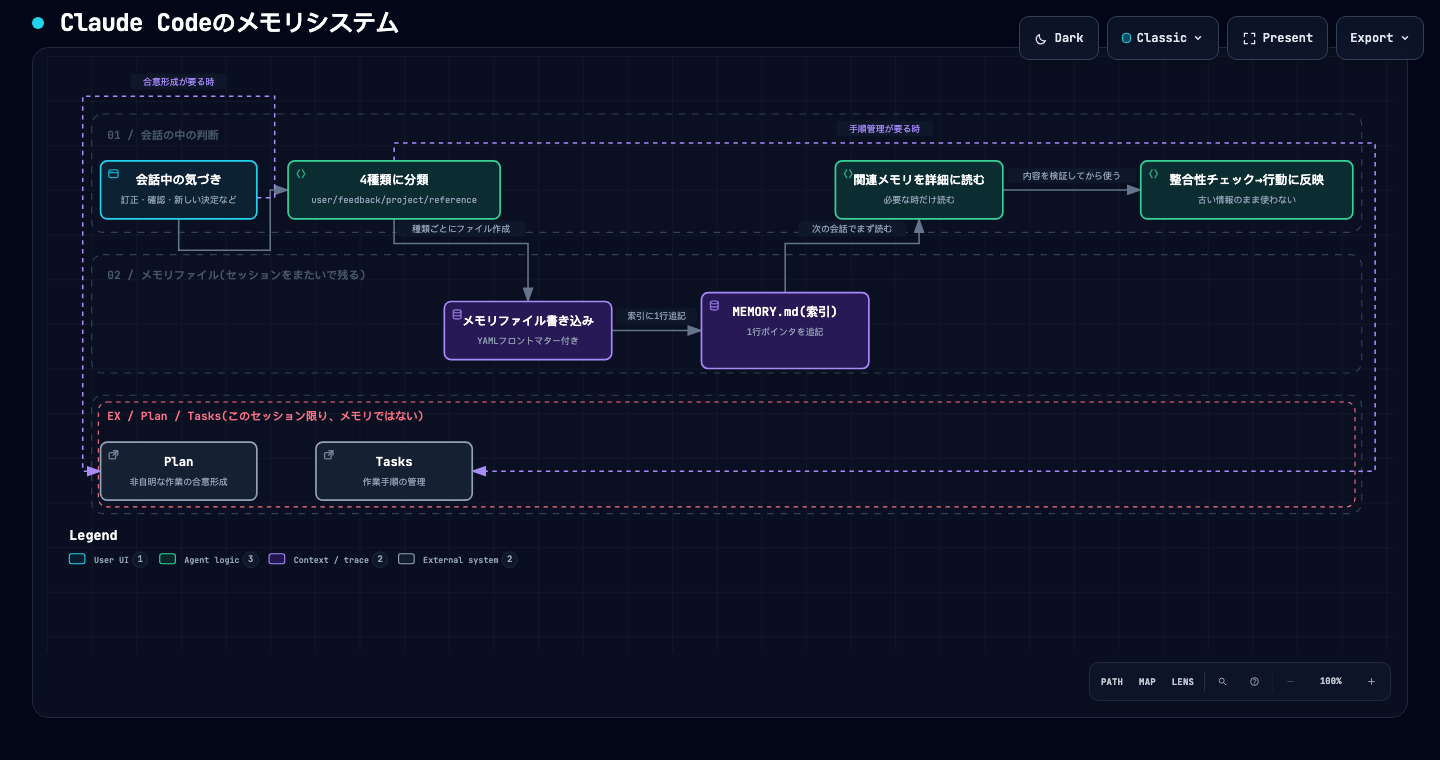
ルールファイルはこちらが手で書いたものですが、それとは別にmemory/というディレクトリがあって、こちらはClaude自身が気づいたことを書き溜めていく仕組みになっています。
公式ドキュメントの言葉を借りると、CLAUDE.mdが「人間が書く指示」なのに対して、Auto memoryは「こちらの指摘や好みをもとにClaudeが自分で書くメモ」という位置づけです。
うちの運用では、メモリを4種類に分類しています。
- user: 運営者の役割・知識レベル・好み(例: WordPress以外にEC-CUBE/Illustratorも使える、等)
- feedback: 指摘・修正されたこと、または「その進め方でよかった」と承認されたこと
- project: 今進行中の案件の背景・決定事項(例: いつから文体をフランク寄りに変えたか)
- reference: 「これはLinearのこのプロジェクトで管理してる」のような、外部の情報源への道しるべ
それぞれが独立した1ファイルになっていて、MEMORY.mdという索引ファイルに一覧が並んでいます。
セッションを始めるたびに、この索引がまず目に入る仕組みです。
実際に「効いた」瞬間と、効かなかった瞬間
一番分かりやすく効いたのが、WordPressのWP-CLI操作でのちょっとした事故でした。
wp post term addというコマンドで記事にカテゴリを割り当てようとしたとき、数字(カテゴリID)をそのまま渡したら、実はterm名として解釈されて「11」「12」という意味不明な名前のカテゴリが6個も新規作成されてしまったことがありました。
エラーは一切出ず「Success」と表示されるタイプの罠だったので、これは危ないと思って、すぐにClaudeにメモリへ書き残してもらいました。「term_idを使う場合は--by=idを必ず付ける」という具体的な回避策とセットです。
ただ、正直に言うと万能ではありません。
本番DBを操作するときは「必ずスラッグ(記事のURL末尾の文字列)で対象を特定する、投稿IDを決め打ちしない」というルールも、実はClaudeが一度メモリに書いていたあとに、別の作業で自分がうっかりローカルのIDをそのまま本番のスクリプトに使い回してしまい、5件とも失敗する、という事故を起こしています。
知識として知っていることと、スクリプトを書く瞬間にその知識が実際に手を止めさせてくれるかは、別の話なんだなと実感しました。
この一件は「過去に学んだはずの教訓を、また一度破ってから再確認した」という経緯ごと、メモリの方にもClaudeに書き直してもらいました。失敗も含めて記録しておく方が、次に似た場面で立ち止まれる確率が上がる気がしています。
何でも書けばいいわけではない
メモリを運用していく中で、逆に「これは書かない」というルールも自然と固まってきました。
コードを読めば分かること(ファイル構成、命名パターン)や、git logを見れば分かること(誰が何を変えたか)は、あえてメモリに書きません。
理由はシンプルで、コードやgit履歴は常に最新の状態が正なので、メモリに二重に持つとどちらが正しいか分からなくなる時期が来るからです。
メモリに残す価値があるのは、コードを読んでも分からないもの、つまり「なぜそう決めたか」「過去に何を試して失敗したか」「ユーザーがどう感じたか」といった、その場に居合わせないと分からない文脈の方です。
この線引きに気づいてからは、メモリの中身が変に膨らまなくなった気がします。
まとめ
CLAUDE.mdとルールファイルは「毎回守ってほしい、変わらないルール」を人間が書く場所、メモリは「やってみて分かったこと」をAI自身が書き溜める場所。
役割を分けたことで、同じ指摘を何度も繰り返す場面はかなり減りました。
ただ今回書いていて改めて思ったのは、この仕組みは「一度書けば二度と同じ失敗をしない魔法の箱」ではなく、書いた教訓を実際の場面でちゃんと参照できるかどうかは結局その都度次第、ということです。
それでも、何も残さずに毎回ゼロから説明し直すよりは、確実にマシになっている実感があります。地味な仕組みですが、地道に育てていく価値はあるなと思っています。
この記事が参考になったら、応援クリックをお願いします